Mis servicios autohospedados se utilizan a diario. La monitorización evoluciona con ellos: Zabbix 7.0 LTS, agentes desplegados automáticamente, plantillas adaptadas y alertas Matrix con respaldo SMS.
Contenido
Presento mi enfoque y una arquitectura simplificada. Las interfaces están reconstruidas con datos de ejemplo. Simulo fallos de sedes virtualmente; varias VM en una misma ubicación no sustituyen sedes físicas separadas.
Incorporar equipos con un proceso repetible
Ansible gestiona instalación, configuración e incorporación del agente. Durante el despliegue el agente solicita un certificado a FreeIPA. Cada agente recibe una identidad individual para sus conexiones TLS.
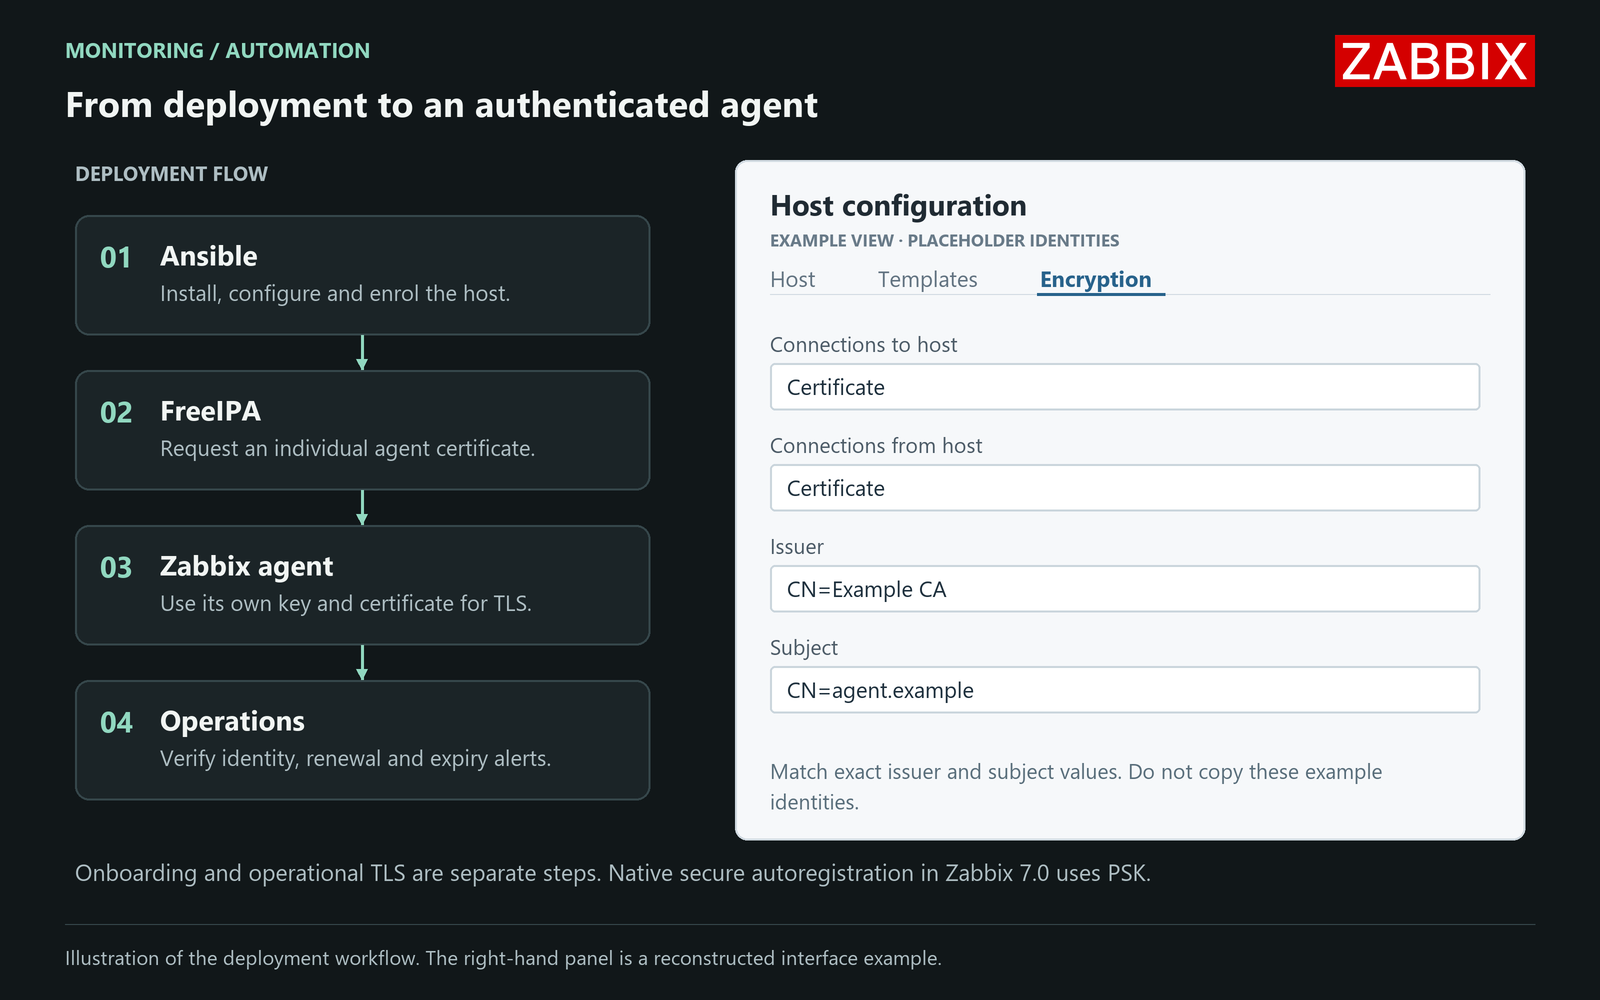
Incorporación y autenticación operativa son distintas. El autorregistro seguro nativo de Zabbix 7.0 usa PSK; las conexiones con certificados requieren otra configuración. La automatización debe cubrir expresamente ambas tareas.
Importan la CA de confianza y la identidad esperada. Zabbix permite restringir emisor y sujeto. Aceptar cualquier certificado de una CA interna de uso amplio sería demasiado permisivo. Permisos de claves privadas, renovación y control de caducidad forman parte del proceso.
Zero Trust también en la monitorización
Mi red interna no recibe confianza implícita. Trato los accesos internos con el mismo cuidado que los públicos: conexiones autorizadas expresamente, identidades verificadas y permisos mínimos. En monitorización se traduce en certificados individuales de agentes, cuentas de servicio limitadas y flujos de comunicación definidos.
Adaptar plantillas al servicio
Servidores web, bases y pruebas de aplicaciones forman gran parte de mi monitorización. Parto de plantillas existentes y adapto intervalos, umbrales y disparadores. Añado pruebas propias cuando falta una respuesta importante.
Una prueba HTTP puede evaluar estado, latencia y contenido esperado. Una prueba de base de datos puede observar conexiones o una consulta acotada. Discos, temperaturas e interfaces aportan contexto de hardware. Son ejemplos de diseño, no una exportación de mi configuración.
Cada prueba necesita definir éxito y tiempo máximo. Los datos ausentes deben seguir visibles. Las cuentas solo necesitan los permisos de lectura útiles. SNMPv3 requiere authPriv para autenticar y cifrar; HTTPS y API deben validar certificados. Las reglas de red limitan también los interlocutores.
Partir del impacto y buscar la causa
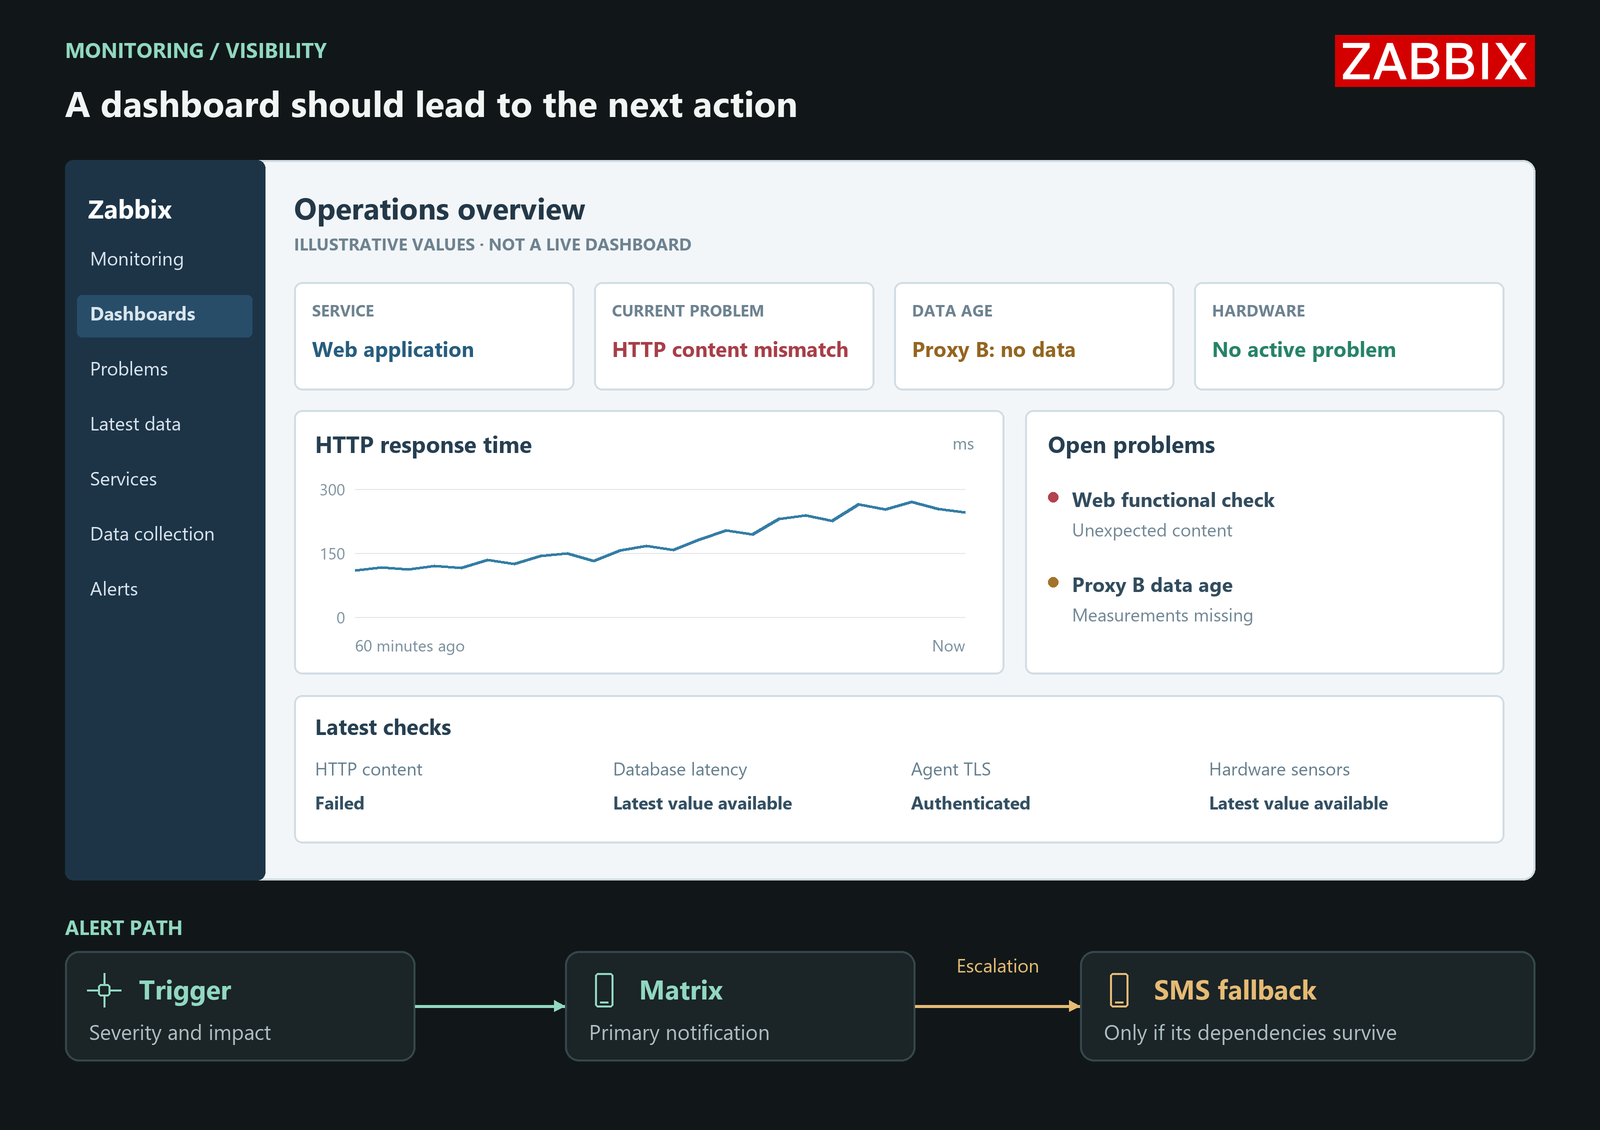
La primera pregunta es qué servicio está afectado. Combinaría problemas abiertos, última medición y unas pocas curvas útiles. En el ejemplo, un dato antiguo sigue como “No data” en vez de indicar que todo está bien.
Las vistas de detalle permiten investigar errores HTTP, conexiones de base, recursos y sensores. SIEM y análisis centralizado de registros añaden contexto de seguridad y diagnóstico. Su función es diferente de vigilar disponibilidad y rendimiento.
El housekeeping forma parte de la operación
Planifico intervalos y conservación conjuntamente. History mantiene detalle reciente; Trends permite analizar valores numéricos durante más tiempo. Eventos y datos de auditoría tienen finalidades y plazos propios.
Hay que observar crecimiento de la base, espacio y si la limpieza mantiene el ritmo. Un plazo idéntico para todos los elementos puede generar carga innecesaria. La eliminación también depende del motor y particionado de la base.
Dos servidores no completan el diseño HA
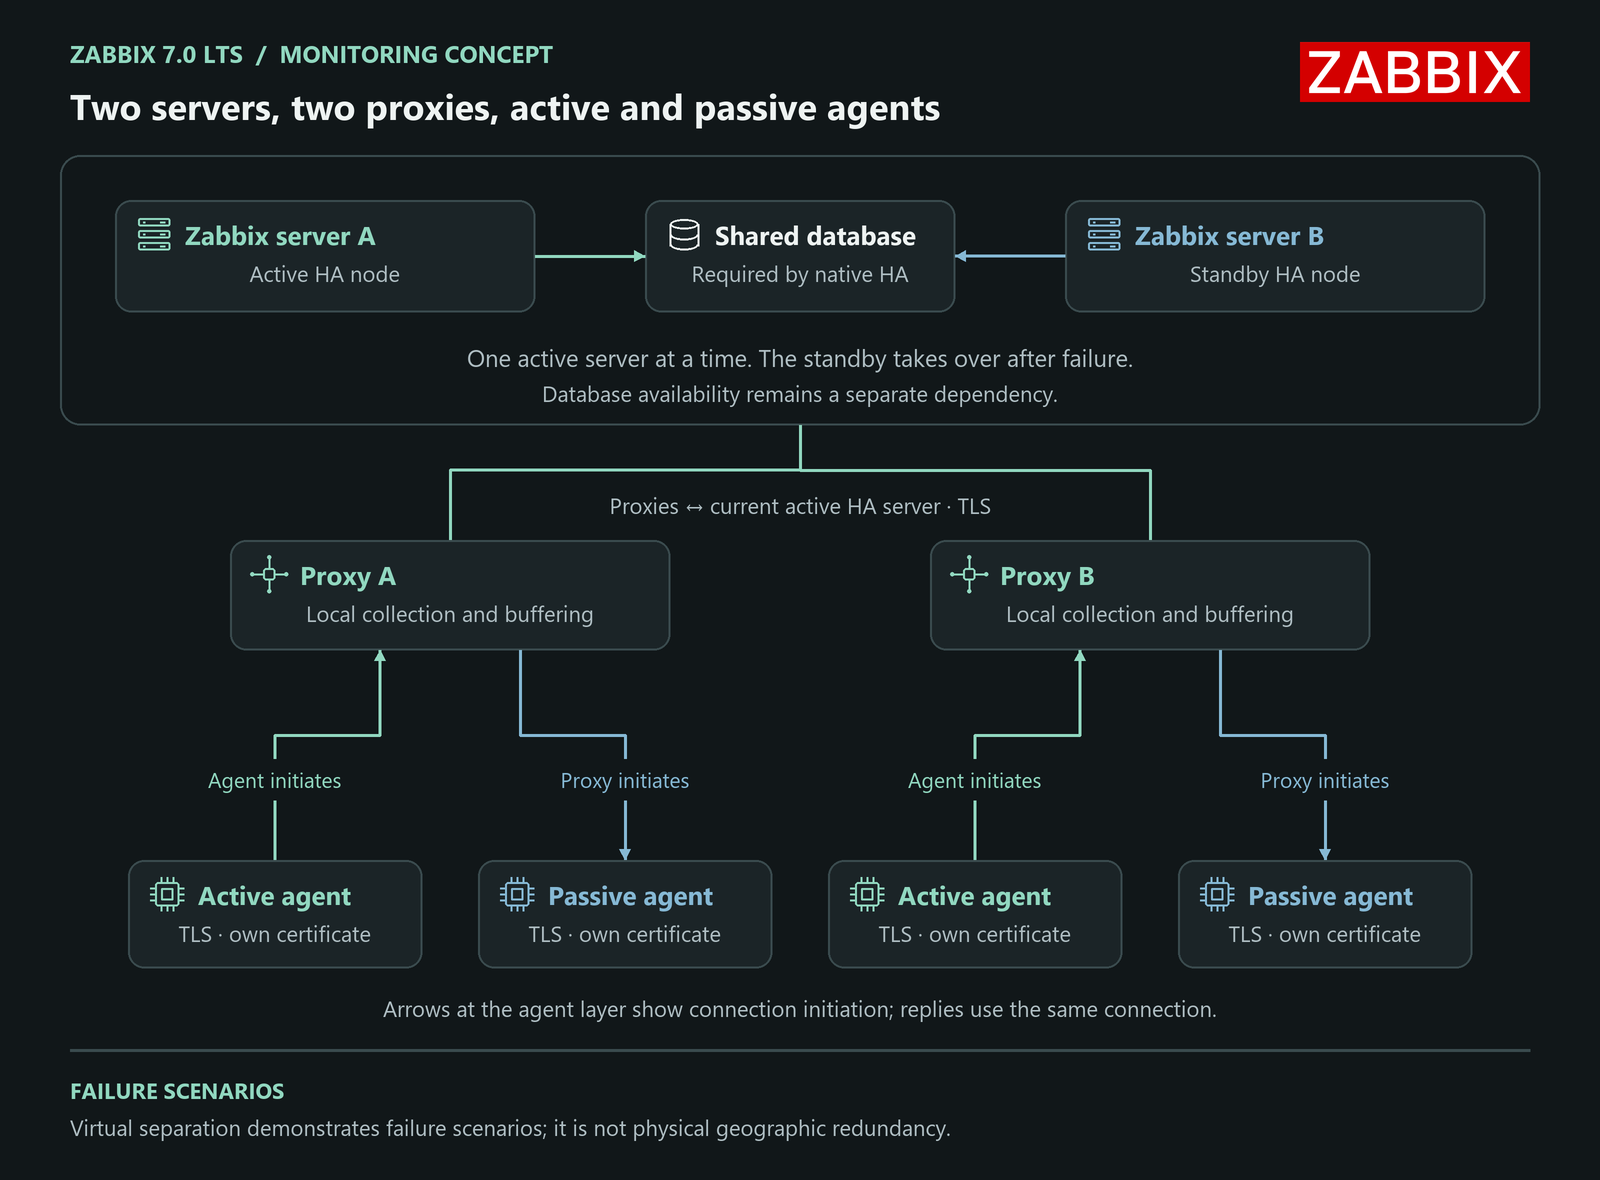
El esquema utiliza HA nativa: un nodo activo y otro en espera dependen de la misma base. Su disponibilidad sigue siendo un problema separado. Los proxies recopilan cerca de los equipos y pueden almacenar temporalmente valores ya recogidos si se interrumpe la conexión al servidor.
El agente activo inicia su conexión; en las pruebas pasivas el proxy consulta al agente. La HA de proxies se configura por separado. No basta con instalar dos: grupo, asignación, configuración del agente y versiones compatibles deben coincidir.
Probar también la entrega de alertas
Mis avisos utilizan Matrix con un módulo SMS de respaldo. Fail2ban revisa patrones definidos y comunica eventos también por correo. Busco una explicación útil del impacto y una escalada razonable, sin multiplicar avisos iguales.
| Fallo controlado | Evidencia esperada |
|---|---|
| Agente o conexión detenidos | Datos ausentes visibles; una medición antigua no representa el estado actual. |
| Servidor activo detenido | Comprobar relevo, retorno del flujo y valores retrasados. |
| Proxy o base detenidos | Probar esa dependencia sin deducirla de la HA de servidores. |
| Matrix inaccesible | La escalada configurada llega a SMS; incluir sus dependencias. |
SMS solo es un respaldo fiable si sus componentes sobreviven al fallo considerado. Un equipo, Internet o circuito eléctrico compartido puede afectar a ambos canales. Las pruebas virtuales revelan dependencias, pero no demuestran resiliencia física entre sedes.
Conclusión
Para mí, la utilidad está en unir incorporación repetible, conexión autenticada, resultado comprensible y un aviso que llegue a quien pueda actuar.
Referencias técnicas: Zabbix 7.0: certificate authentication · Autoregistration · Server HA · Proxy groups · Housekeeping · Zero Trust: NIST SP 800-207