I miei servizi self-hosted vengono usati ogni giorno. Il monitoraggio cresce con loro: Zabbix 7.0 LTS, deployment automatizzato degli agent, template adattati e notifiche Matrix con fallback SMS.
Indice
Presento il mio approccio con un’architettura semplificata. Le interfacce sono ricostruite con dati di esempio. Simulo virtualmente guasti di sedi; più VM nello stesso sito non sostituiscono sedi fisiche separate.
Integrare un host con un processo ripetibile
Ansible gestisce installazione, configurazione e integrazione dell’agent. Durante il deployment l’agent richiede un certificato a FreeIPA. Ogni agent possiede un’identità personale per le connessioni TLS.
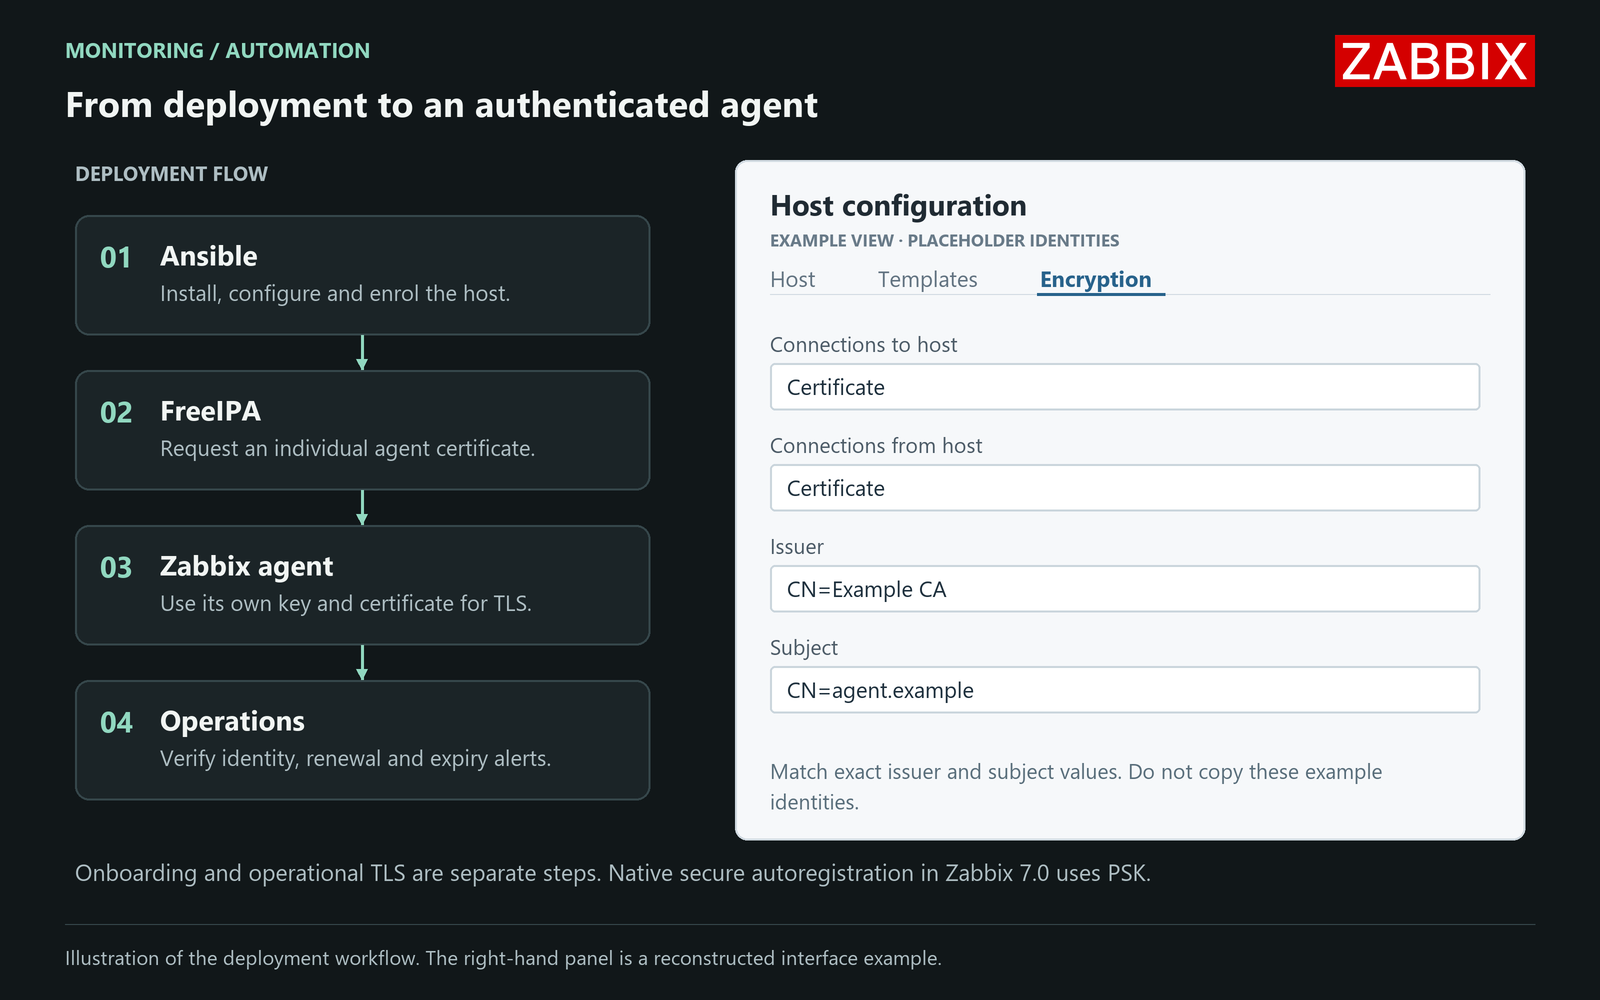
Integrazione e autenticazione operativa sono fasi distinte. La registrazione automatica sicura nativa di Zabbix 7.0 usa PSK; le connessioni con certificato richiedono una configurazione separata. L’automazione deve coprire entrambe.
Contano sia la CA fidata sia l’identità attesa. Zabbix permette restrizioni su emittente e soggetto. Accettare qualsiasi certificato di una CA interna molto usata sarebbe troppo ampio. Permessi delle chiavi private, rinnovo e controllo delle scadenze fanno parte del processo.
Zero Trust vale anche per il monitoraggio
La mia rete interna non riceve fiducia implicita. Tratto gli accessi interni con la stessa attenzione di quelli pubblici: connessioni autorizzate esplicitamente, identità delle controparti verificata e permessi limitati al necessario. Nel monitoraggio significa certificati individuali degli agenti, account di servizio limitati e percorsi di comunicazione definiti.
Adattare i template al servizio
Web server, database e controlli applicativi costituiscono gran parte del mio monitoraggio. Parto dai template esistenti e adatto intervalli, soglie e trigger. Aggiungo controlli personalizzati quando manca un’informazione utile.
Un controllo HTTP può valutare stato, latenza e contenuto atteso. Un controllo database può esaminare connessioni o durata di una query limitata. Dischi, temperature e interfacce completano il quadro hardware. Sono esempi di progettazione, non un export della mia configurazione.
Ogni controllo deve definire successo e timeout. I dati mancanti devono rimanere visibili. Gli account richiedono solo i permessi di lettura utili. SNMPv3 necessita di authPriv per autenticazione e cifratura; HTTPS e API devono validare i certificati. Le regole di rete limitano anche gli interlocutori.
Partire dall’impatto e trovare la causa
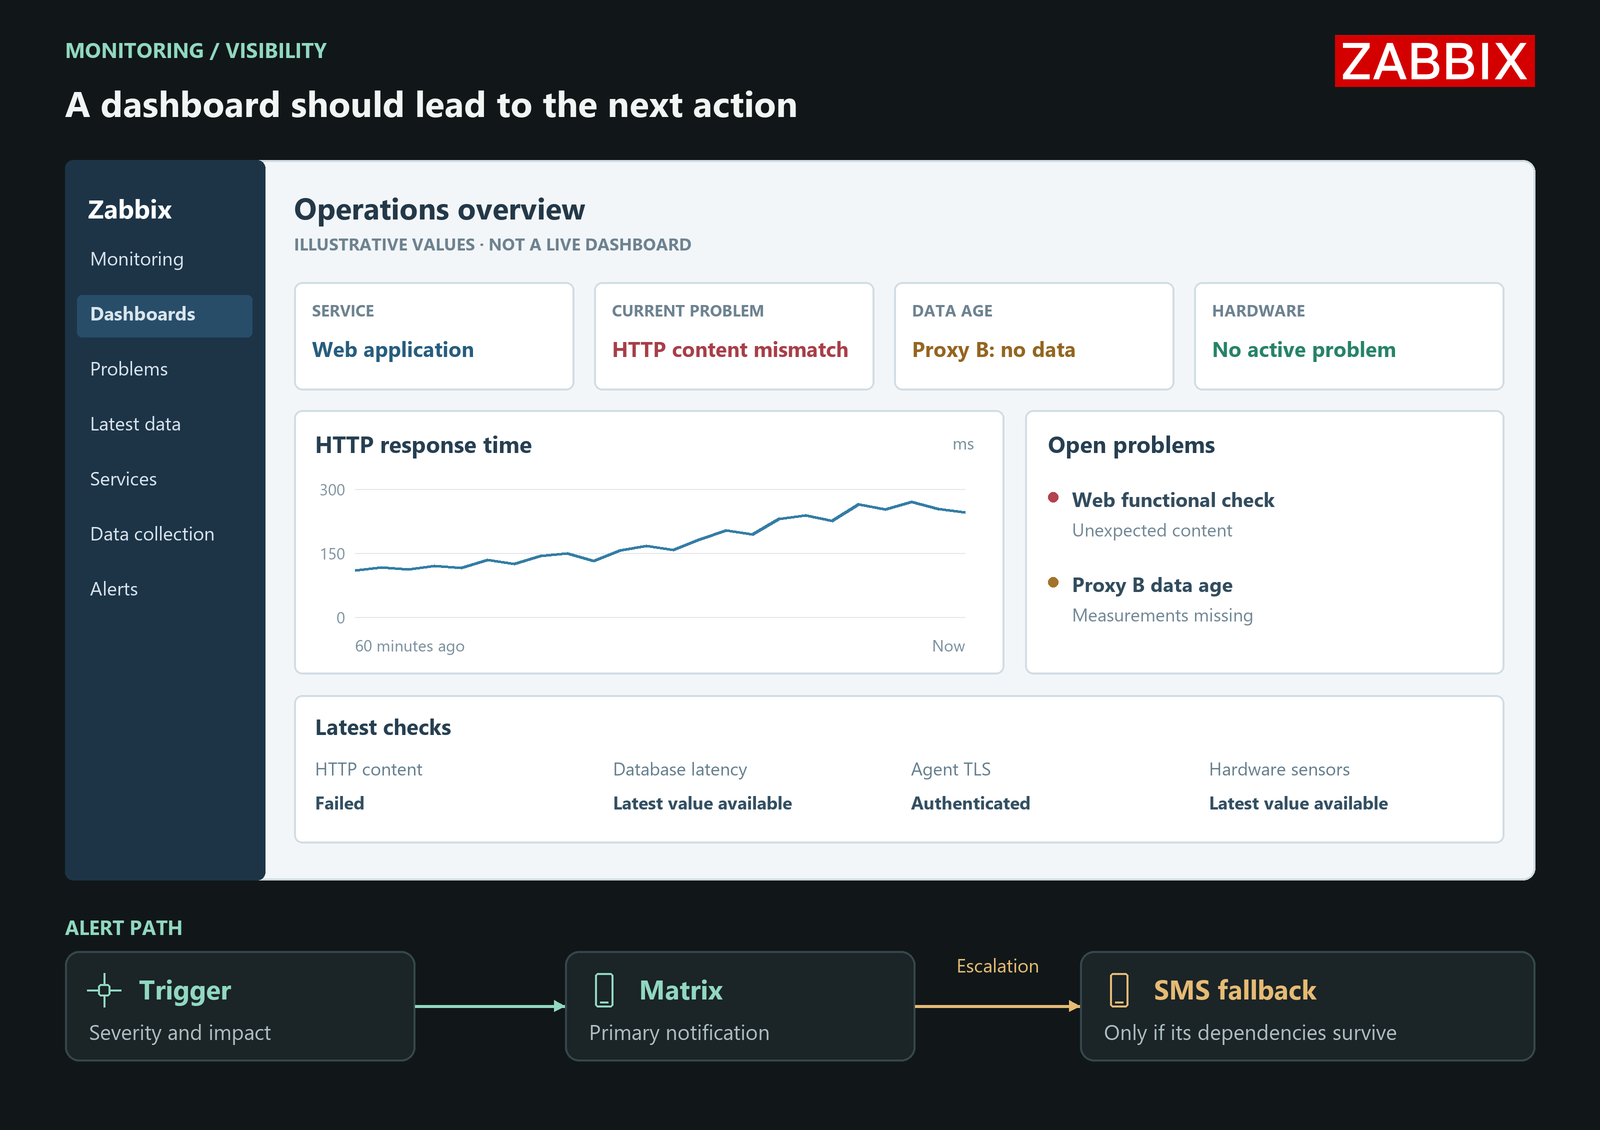
La prima domanda è quale servizio sia coinvolto. Combinerei problemi aperti, ultima misura e pochi grafici utili. Nell’esempio una misura vecchia rimane “No data”, senza diventare una rassicurazione sullo stato attuale.
Nelle viste dettagliate esamino errori HTTP, connessioni database, risorse e sensori. SIEM e analisi centralizzata dei log aiutano con eventi di sicurezza e diagnosi. Il loro scopo è distinto dal controllo di disponibilità e prestazioni.
L’housekeeping è parte dell’operatività
Pianifico insieme intervalli e conservazione. History offre dettagli recenti; Trends permette analisi più lunghe dei valori numerici. Eventi e dati di audit hanno finalità e tempi propri.
Bisogna seguire crescita del database, spazio e capacità della pulizia di tenere il passo. La stessa conservazione per tutti gli item può creare carico inutile. La rimozione dei dati dipende anche dal database e dal partizionamento.
Due server non completano il progetto HA
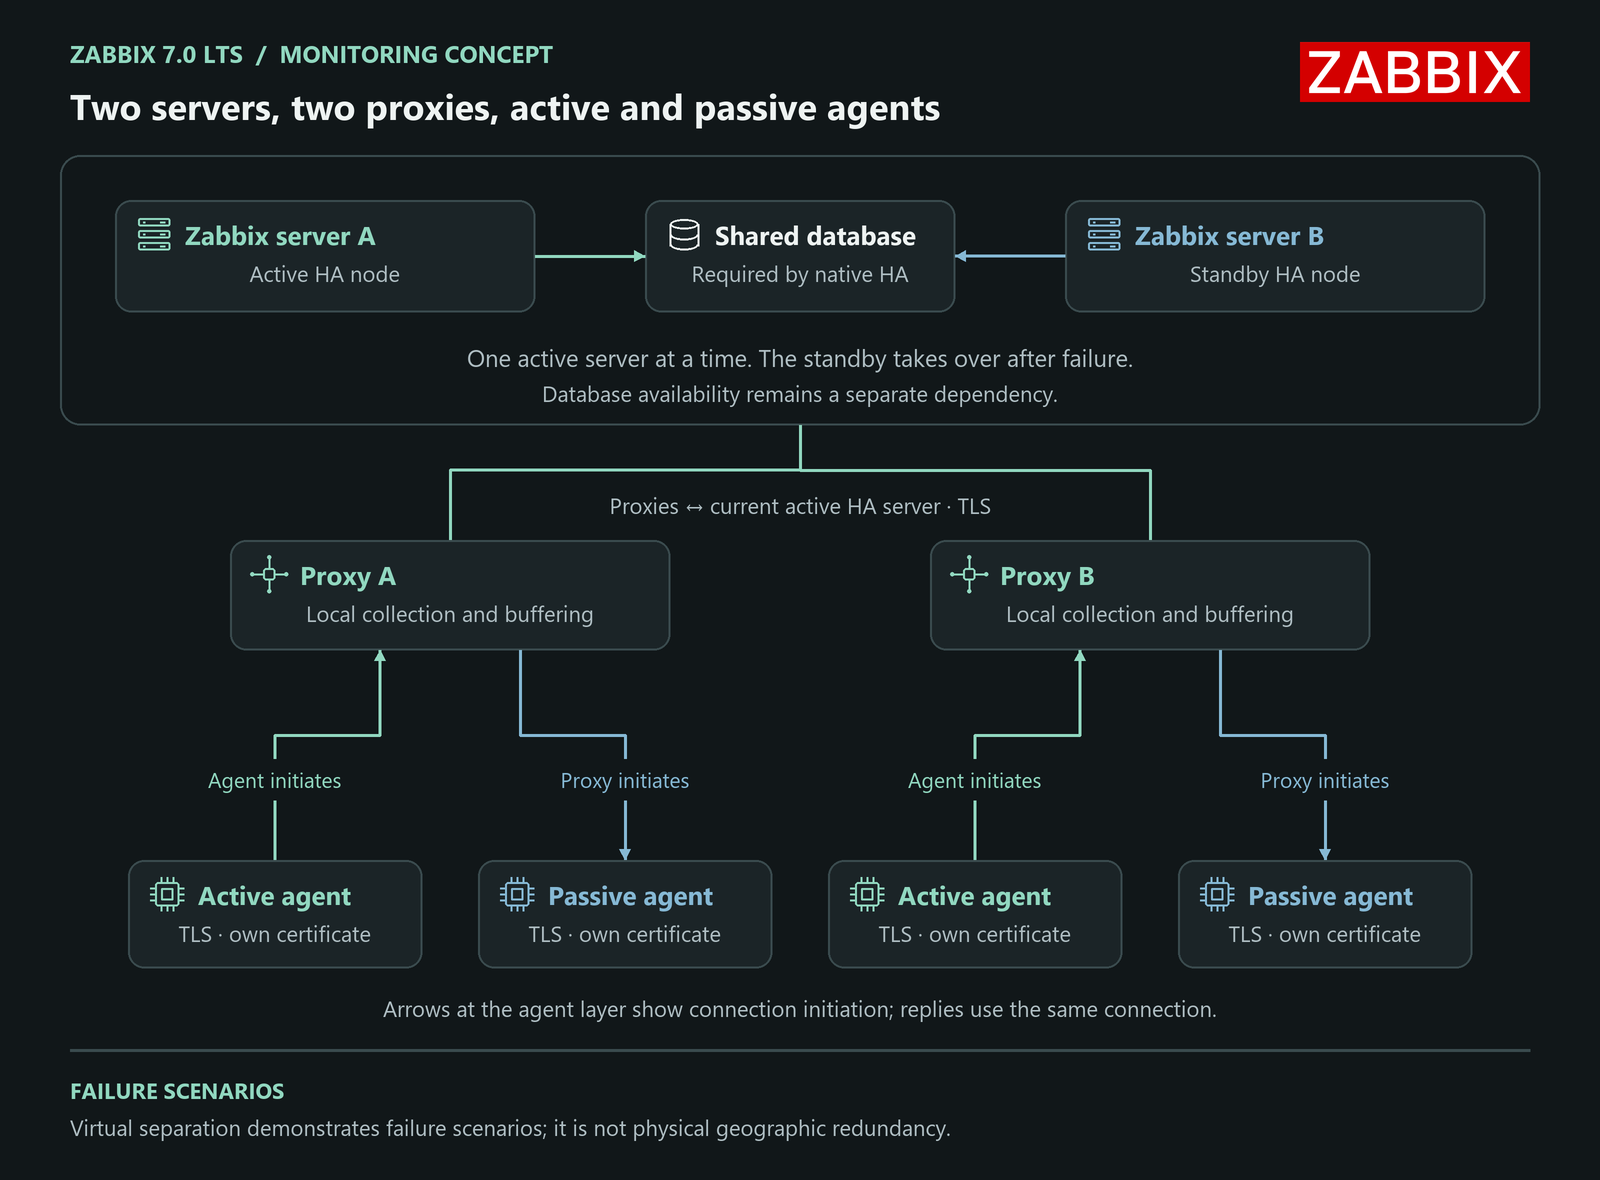
Lo schema usa HA nativa: un nodo attivo e uno standby dipendono dallo stesso database. La disponibilità del database resta un problema separato. I proxy raccolgono vicino agli host e possono conservare valori già raccolti mentre la connessione al server è interrotta.
Un agent attivo avvia la connessione; nei controlli passivi il proxy interroga l’agent. HA dei proxy richiede una configurazione propria: due proxy installati non bastano. Gruppi, assegnazione degli host, configurazione degli agent e versioni devono essere coerenti.
Provare anche il percorso di notifica
Le mie notifiche usano Matrix e un modulo SMS di fallback. Fail2ban analizza pattern definiti e comunica eventi anche via e-mail. Mi servono un impatto comprensibile e un’escalation sensata, senza moltiplicare avvisi identici.
| Guasto controllato | Risultato atteso |
|---|---|
| Agent o connessione interrotti | Dati mancanti visibili; una vecchia misura riuscita non indica lo stato presente. |
| Arresto del server attivo | Verificare subentro, ripresa del flusso e valori ritardati. |
| Arresto di proxy o database | Provare la singola dipendenza senza dedurla dalla HA dei server. |
| Matrix non raggiungibile | L’escalation configurata raggiunge SMS; verificare anche le sue dipendenze. |
SMS è un fallback affidabile solo se i componenti necessari sopravvivono al guasto considerato. Host, Internet o alimentazione comuni possono colpire entrambi i canali. I test virtuali evidenziano dipendenze, ma non dimostrano resilienza fisica tra sedi.
Conclusioni
Per me il valore sta nel collegare integrazione ripetibile, connessione autenticata, risultato comprensibile e un messaggio ricevuto da chi può intervenire.
Riferimenti tecnici: Zabbix 7.0: certificate authentication · Autoregistration · Server HA · Proxy groups · Housekeeping · Zero Trust: NIST SP 800-207