Mes services auto-hébergés sont utilisés au quotidien. Ma supervision évolue donc avec eux : Zabbix 7.0 LTS, déploiement automatisé des agents, modèles adaptés et alertes Matrix avec un secours SMS.
Sommaire
Cet article présente mon approche et une architecture simplifiée. Les interfaces sont reconstituées avec des données d’exemple. Je simule les pannes de sites virtuellement ; plusieurs VM dans un même site ne remplacent pas des sites physiques distincts.
Intégrer un hôte avec un processus reproductible
Ansible prend en charge installation, configuration et intégration de l’agent. Pendant le déploiement, l’agent demande un certificat à FreeIPA. Chaque agent possède ainsi sa propre identité pour les connexions TLS.
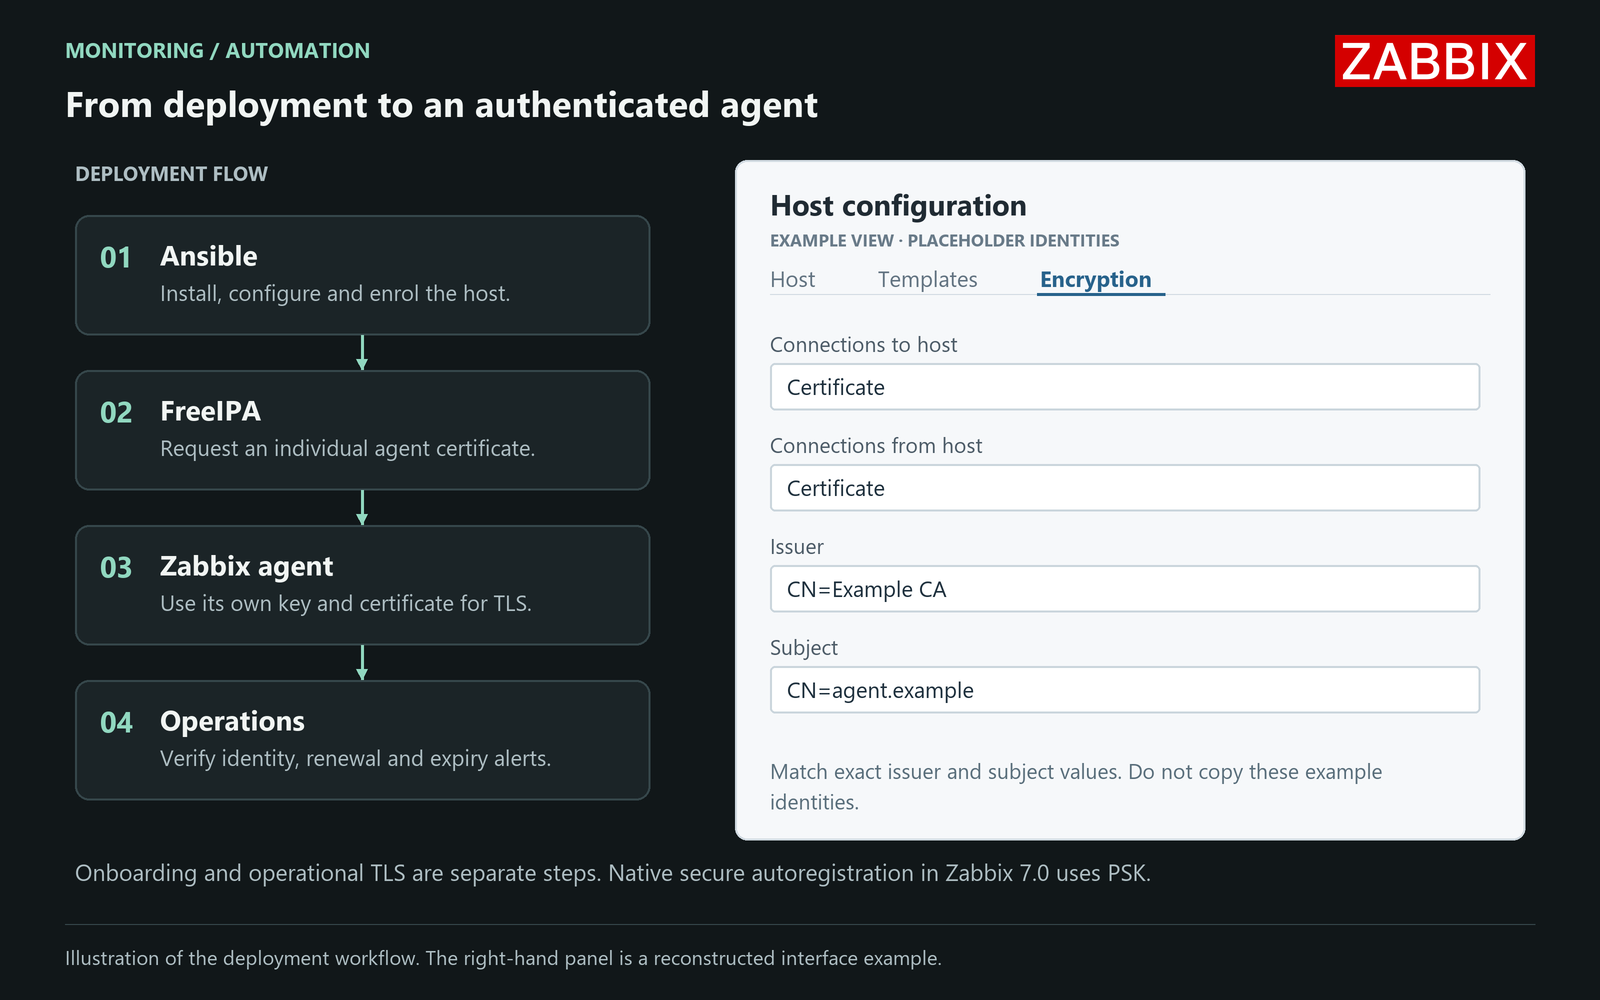
Intégration et authentification en fonctionnement sont distinctes. L’auto-enregistrement sécurisé natif de Zabbix 7.0 utilise PSK ; les connexions par certificat nécessitent une configuration séparée. L’automatisation doit traiter explicitement les deux étapes.
Pour TLS, la CA de confiance et l’identité attendue comptent ensemble. Zabbix permet de restreindre émetteur et sujet. Accepter tout certificat issu d’une CA interne largement utilisée serait trop permissif. Droits sur les clés privées, renouvellement et suivi des expirations font partie du processus.
Le Zero Trust vaut aussi pour la supervision
Mon réseau interne ne bénéficie d’aucune confiance implicite. J’applique aux accès internes la même rigueur qu’aux accès publics : autoriser précisément les connexions, vérifier les correspondants et limiter les droits au nécessaire. Pour la supervision, cela signifie certificats individuels des agents, comptes de service limités et flux clairement définis.
Adapter les modèles aux services
Serveurs web, bases et contrôles applicatifs représentent une grande partie de ma supervision. Je pars des modèles existants, puis adapte intervalles, seuils et déclencheurs. J’ajoute des contrôles propres lorsqu’une information utile manque.
Un contrôle HTTP peut examiner statut, temps de réponse et contenu attendu. Pour une base : connexions ou durée d’une requête limitée. Disques, températures et interfaces apportent le contexte matériel. Ce sont des exemples de conception, pas un export de ma configuration.
Un contrôle doit définir succès et délai maximal. Données absentes et dépassements de délai doivent rester visibles. Les comptes ne nécessitent que les droits de lecture utiles. SNMPv3 demande authPriv pour authentifier et chiffrer ; HTTPS et les API doivent valider les certificats. Les règles réseau limitent également les interlocuteurs.
Partir de l’impact pour trouver la cause
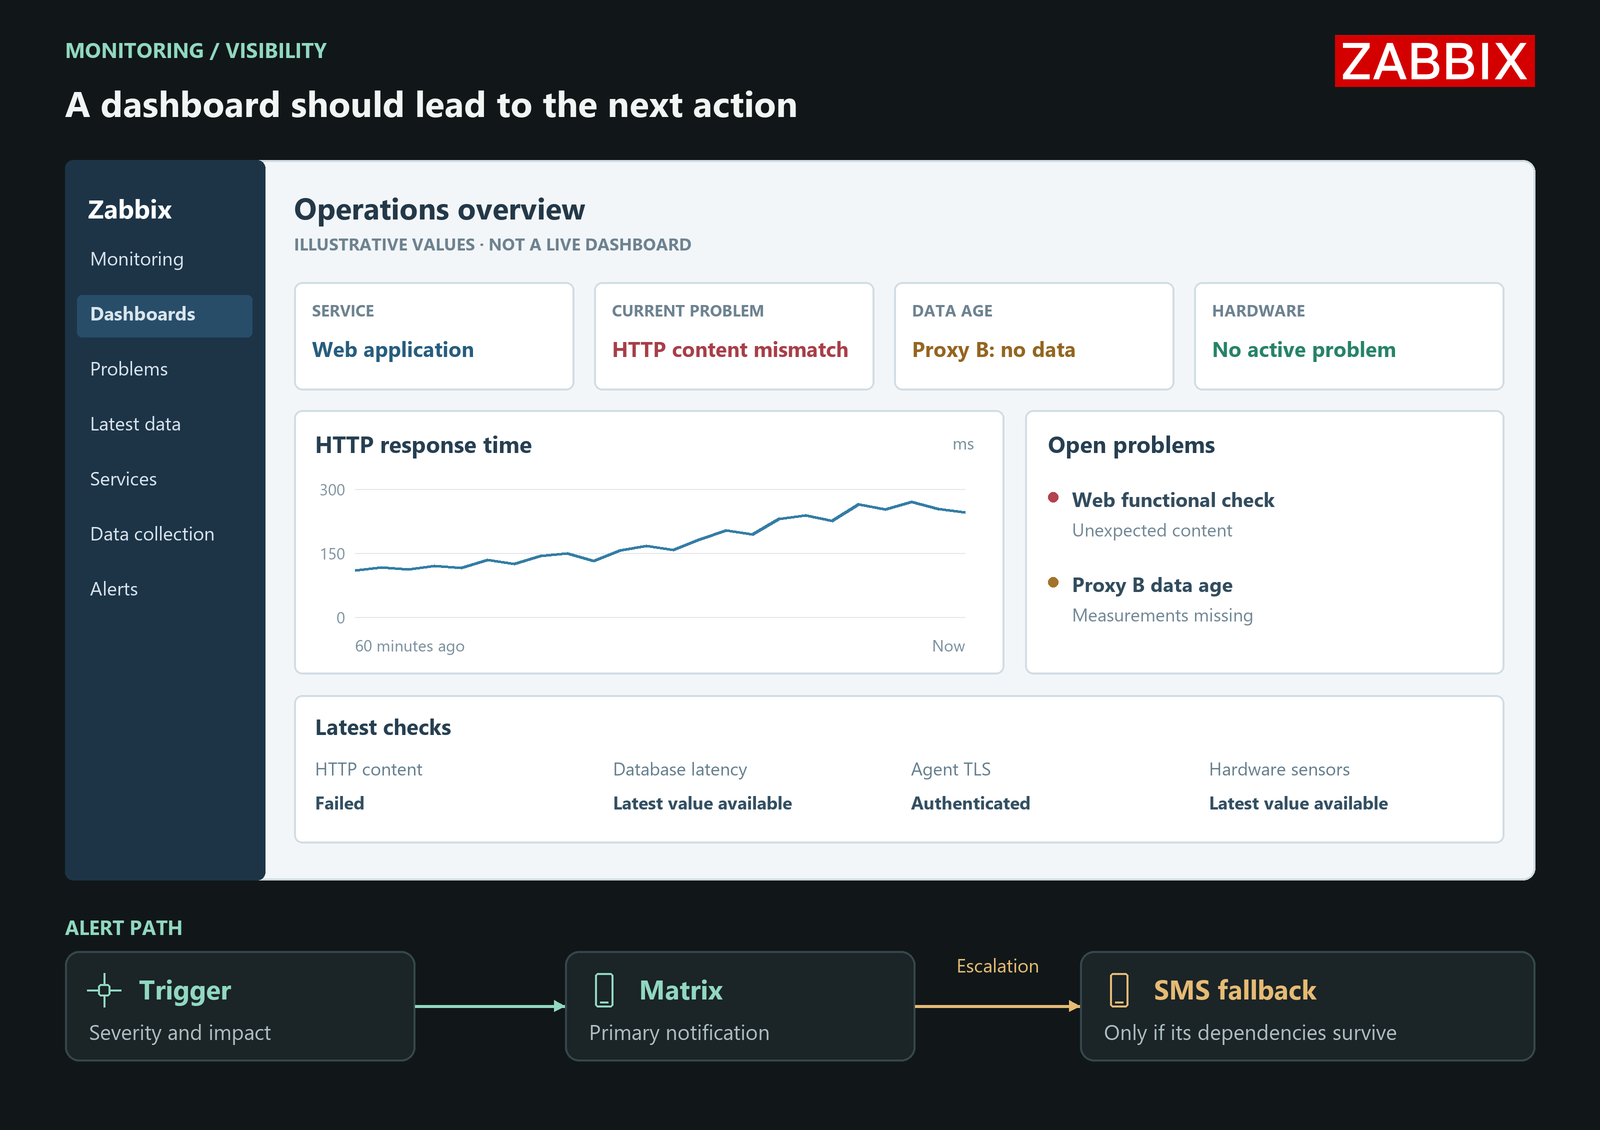
Ma première question est de savoir quel service est concerné. Je combinerais problèmes ouverts, dernière mesure et quelques courbes utiles. Dans l’exemple, une valeur périmée reste « No data » et ne devient pas un signe de bon fonctionnement.
Les vues détaillées permettent ensuite d’examiner erreurs HTTP, connexions de base, ressources et capteurs. SIEM et analyse centralisée des journaux complètent l’enquête sur les événements de sécurité. Leur rôle diffère du suivi de disponibilité et de performances.
Le housekeeping fait partie de l’exploitation
Je planifie ensemble intervalles et conservation. History garde le détail pour les investigations récentes ; Trends permet l’analyse prolongée des métriques numériques. Événements et données d’audit ont leurs propres finalités et durées.
Il faut suivre croissance de la base, espace consommé et capacité du nettoyage à suivre. Une durée identique pour chaque item peut créer une charge inutile. Le mécanisme de suppression dépend aussi du moteur de base et du partitionnement.
Deux serveurs ne suffisent pas à terminer la HA
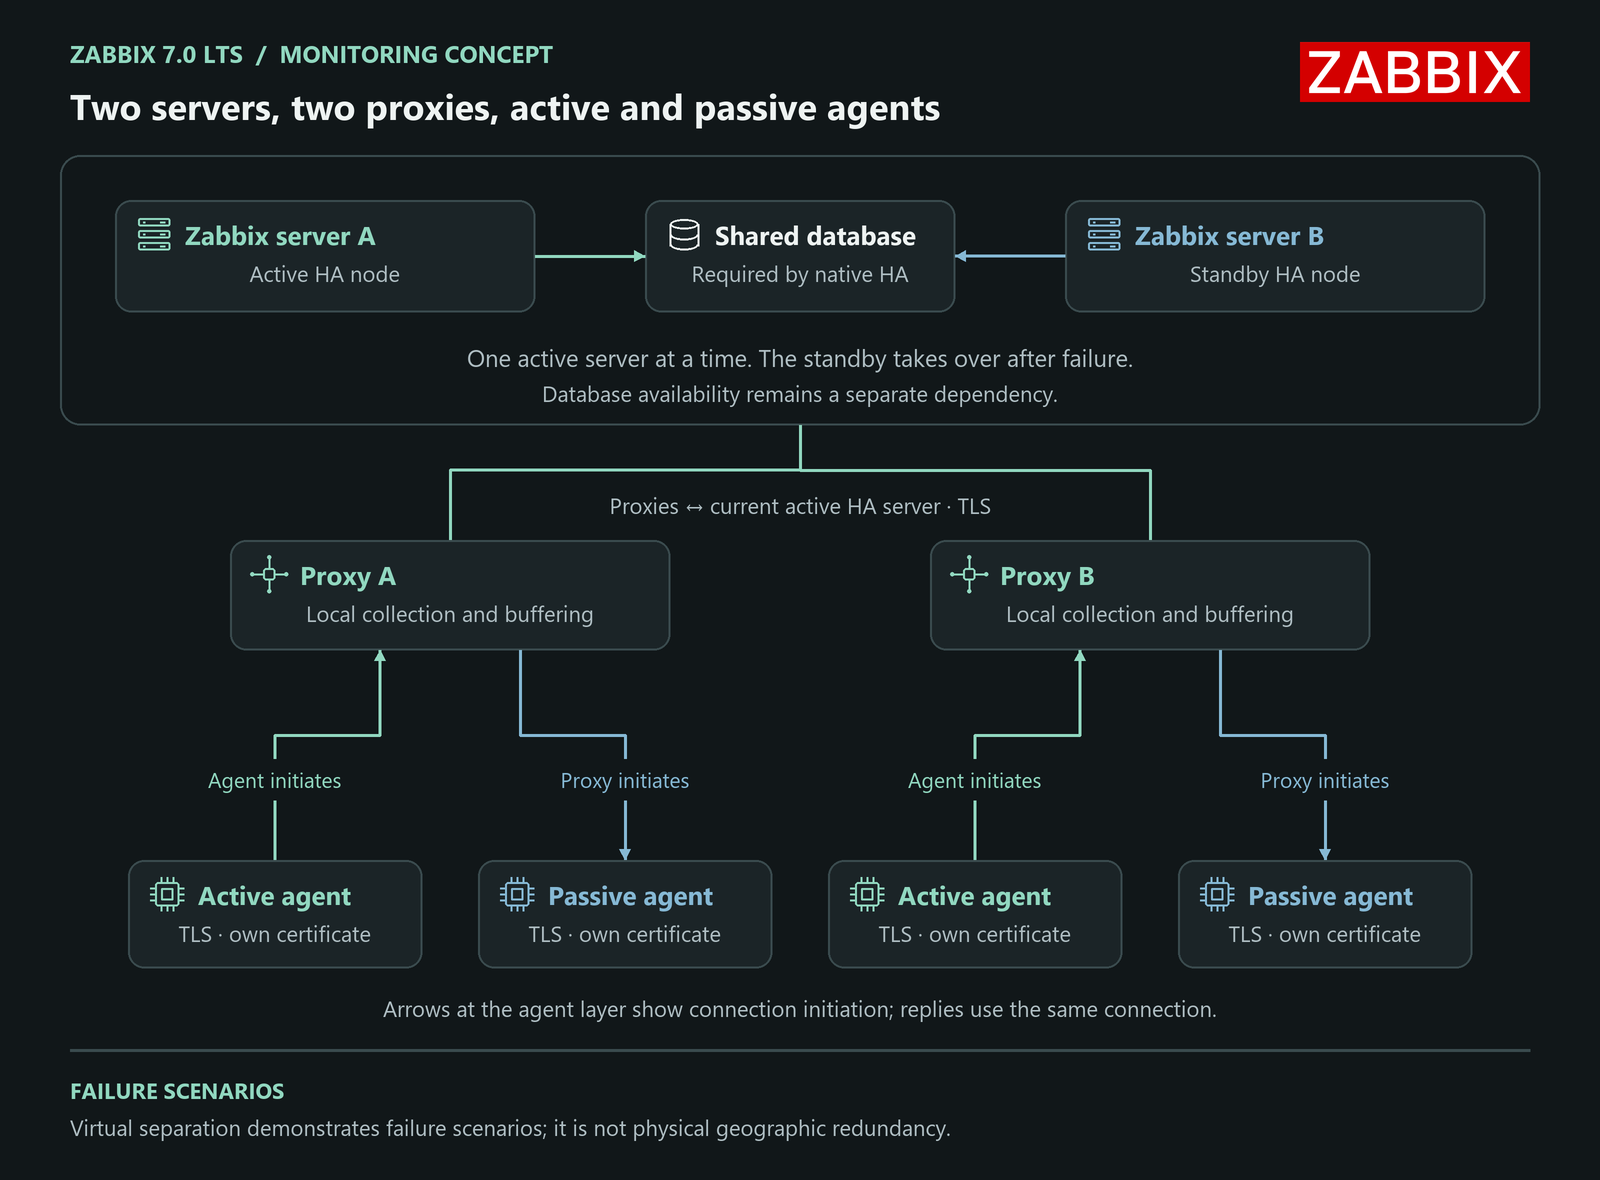
La figure utilise la HA native : un nœud actif et un secours, tous deux dépendants d’une base partagée. La disponibilité de cette base reste une question séparée. Les proxies collectent près des hôtes et peuvent conserver temporairement les valeurs déjà recueillies si la liaison avec le serveur est interrompue.
Un agent actif initie sa connexion ; pour les contrôles passifs, le proxy interroge l’agent. La HA des proxies se configure séparément. Deux proxies installés ne suffisent pas : groupe, attribution des hôtes, configuration des agents et versions compatibles doivent correspondre.
Tester aussi le chemin des alertes
Mes notifications passent par Matrix avec un module SMS de secours. Fail2ban analyse des motifs définis et signale aussi des événements par e-mail. Je recherche une description utile de l’impact et une escalade adaptée, plutôt que plusieurs notifications identiques.
| Panne contrôlée | Résultat à vérifier |
|---|---|
| Agent ou connexion interrompus | Données manquantes visibles ; une ancienne mesure réussie ne représente pas l’état présent. |
| Arrêt du serveur actif | Reprise par le secours, retour du flux et valeurs retardées contrôlés. |
| Arrêt d’un proxy ou de la base | Tester cette dépendance plutôt que déduire sa disponibilité de la HA des serveurs. |
| Matrix inaccessible | L’escalade configurée atteint les SMS ; vérifier aussi leurs dépendances. |
Le secours SMS est fiable seulement si ses composants survivent à la panne considérée. Hôte, liaison Internet ou circuit électrique commun peuvent affecter les deux canaux. Les essais virtuels révèlent ces dépendances sans démontrer une résilience physique entre sites.
Conclusion
Une supervision utile relie pour moi une intégration reproductible, une connexion authentifiée, un résultat compréhensible et un message reçu par une personne capable d’agir.
Références techniques: Zabbix 7.0: certificate authentication · Autoregistration · Server HA · Proxy groups · Housekeeping · Zero Trust: NIST SP 800-207