Meine Dienste werden täglich genutzt. Mit Zabbix 7.0 LTS überwache ich ihre Verfügbarkeit und Performance. Dazu gehören automatisiert ausgerollte Agents, angepasste Templates, eigene Checks und eine Alarmierung, die mich auch bei Störungen erreicht.
Inhaltsverzeichnis
Hier zeige ich, wie Deployment, Absicherung und Auswertung zusammenspielen. Die Abbildungen sind vereinfachte Darstellungen mit Beispieldaten; interne Namen und Adressen bleiben außen vor.
Vom neuen Host zum überwachten System
Das Agent-Deployment läuft über Ansible: Installation, Konfiguration und die Aufnahme ins Monitoring sind Teil eines automatisierten Ablaufs. Dabei wird für jeden Agent ein eigenes TLS-Zertifikat von FreeIPA angefordert.
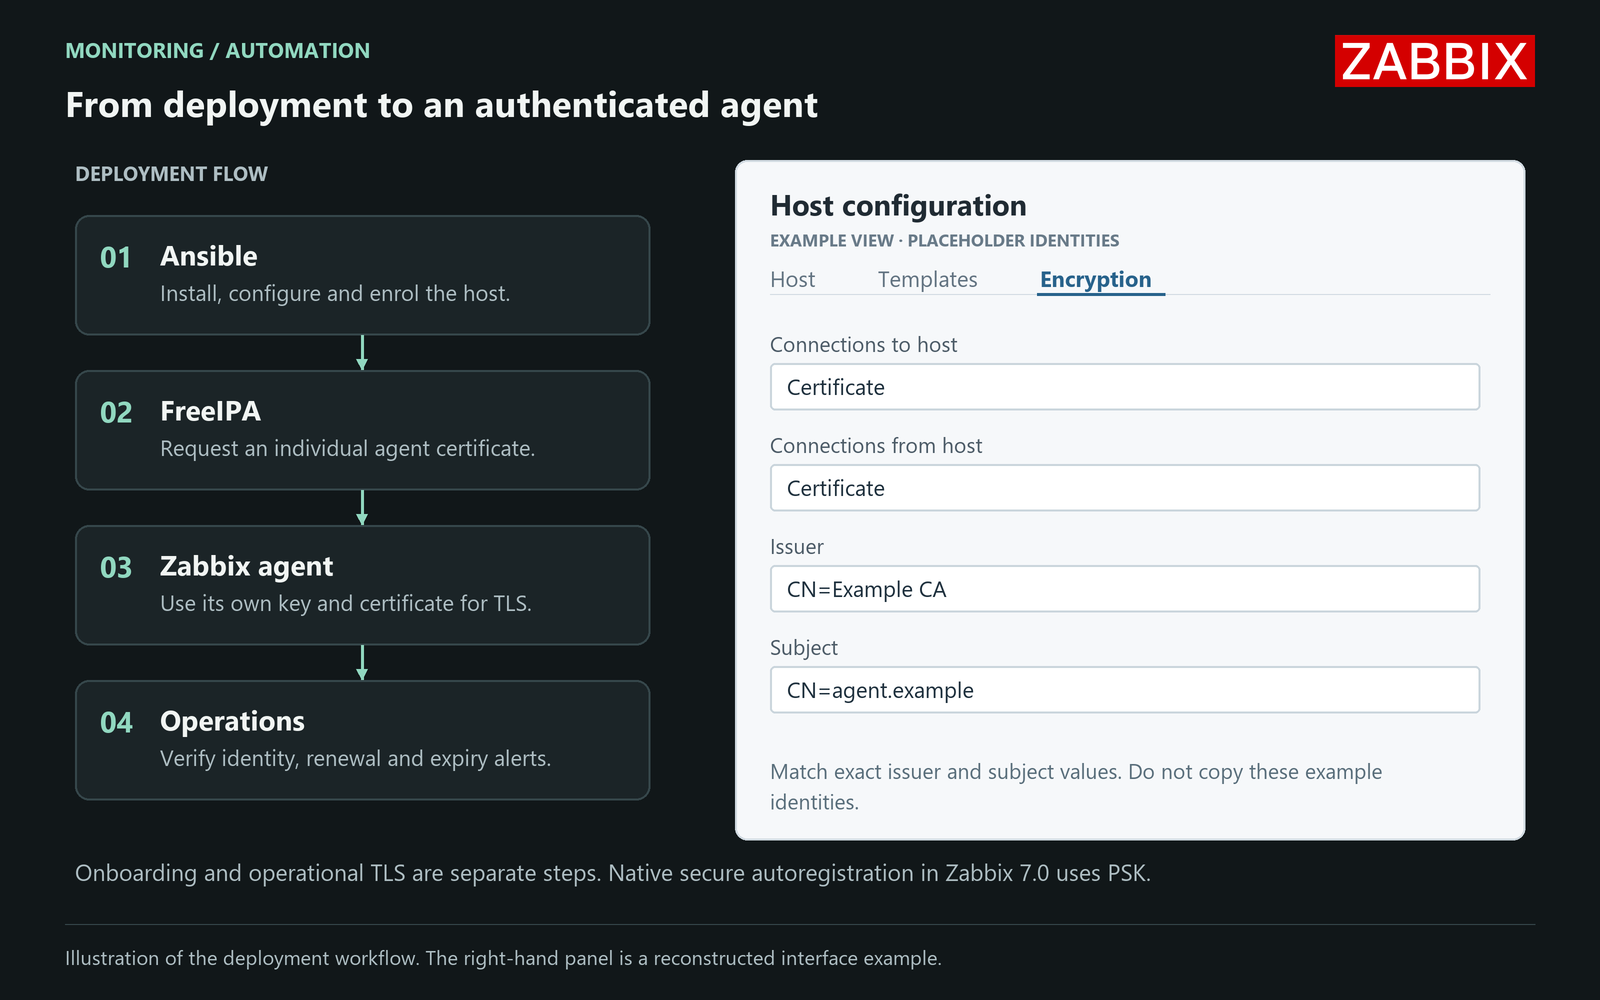
Hostaufnahme und laufende Agent-Verbindung sind dabei zwei verschiedene Schritte. Die native sichere Auto-Registrierung von Zabbix 7.0 verwendet PSK. Die anschließende Kommunikation mit individuellen Zertifikaten wird separat eingerichtet. Beides muss die Automatisierung berücksichtigen.
Bei Zertifikaten zählt auch, welche Gegenstelle sie verwenden darf. Zabbix kann Aussteller und Subject gezielt prüfen. Das ist besonders wichtig, wenn die interne CA Zertifikate für viele verschiedene Dienste ausstellt. Geschützte private Schlüssel, Erneuerung und Ablaufüberwachung gehören ebenfalls dazu.
Zero Trust gilt auch fürs Monitoring
Auch das interne Monitoring ist abgesichert. Ich gebe die benötigten Verbindungen gezielt frei, prüfe die Identität der Gegenstellen und begrenze Berechtigungen. Individuelle Agent-Zertifikate und Dienstkonten mit wenigen Rechten sind Teil dieses Ansatzes.
Templates an den Dienst anpassen
Webserver, Datenbanken und Anwendungen machen einen großen Teil meines Monitorings aus. Fertige Zabbix-Templates nutze ich als Grundlage. Messintervalle, Schwellwerte und Trigger passe ich an den Dienst an; eigene Checks ergänzen die Aussagen, die mir noch fehlen.
Ein Webcheck kann Statuscode, Antwortzeit und erwarteten Inhalt prüfen. Bei einer Datenbank sind beispielsweise die Verbindungen und die Laufzeit einer gezielten Abfrage interessant. Hardware-Checks ergänzen das Bild um Datenträgerzustand, Temperaturen und Schnittstellen.
Ein eigener Check braucht ein klares Ergebnis und ein Zeitlimit. Timeouts und ausbleibende Daten müssen erkennbar bleiben. Für Hardware-Abfragen ist SNMPv3 mit authPriv die Grundlage für Authentifizierung und Verschlüsselung. HTTPS- und API-Checks müssen Zertifikate prüfen; verwendete Zugangsdaten erhalten nur die nötigen Rechte.
Vom Überblick zur Ursache
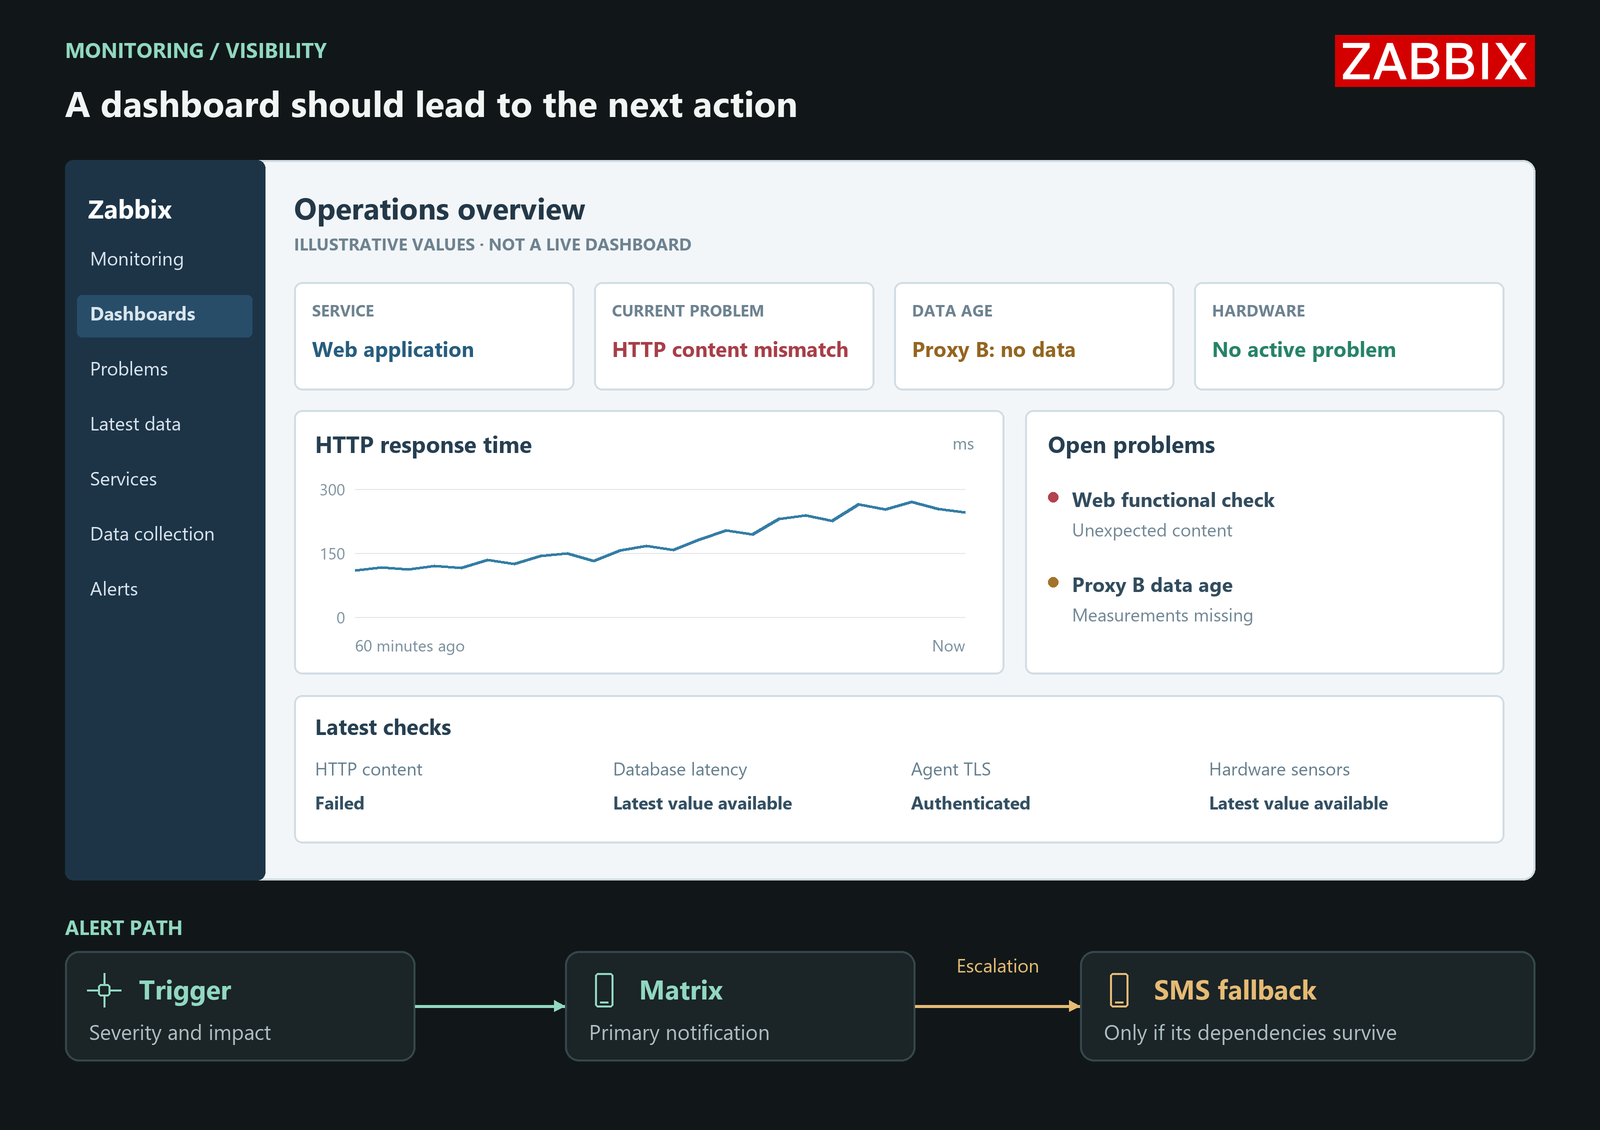
Im Dashboard möchte ich zuerst erkennen, welcher Dienst betroffen ist. Die Beispielansicht verbindet offene Probleme, das Alter der letzten Messung und wenige relevante Verläufe. Ein veralteter Wert wird dabei als fehlende aktuelle Information gekennzeichnet und gibt keine Entwarnung.
Von dieser Übersicht geht es zu den Details: etwa HTTP-Fehlern, Datenbankverbindungen, Ressourcen oder Hardware-Sensoren. SIEM und zentrale Logauswertung ergänzen die Fehlersuche bei Sicherheitsereignissen. Verfügbarkeit, Performance und Sicherheitsanalyse haben jeweils ihre eigene Aufgabe.
Housekeeping gehört zum Betrieb
Housekeeping plane ich zusammen mit den Messintervallen. History hält einzelne Messwerte für die Fehlersuche vor; Trends verdichten numerische Werte für längere Zeiträume. Für Ereignisse und Auditdaten lege ich die Aufbewahrung nach ihrem jeweiligen Zweck fest.
Ich beobachte dabei Datenbankwachstum, Speicherbedarf und die Last durch die Bereinigung. Zu kurze Messintervalle und lange Aufbewahrungszeiten können unnötig Ressourcen binden. Wie alte Daten entfernt werden, hängt auch von der Datenbank und einer möglichen Partitionierung ab.
Hochverfügbarkeit und ihre Abhängigkeiten
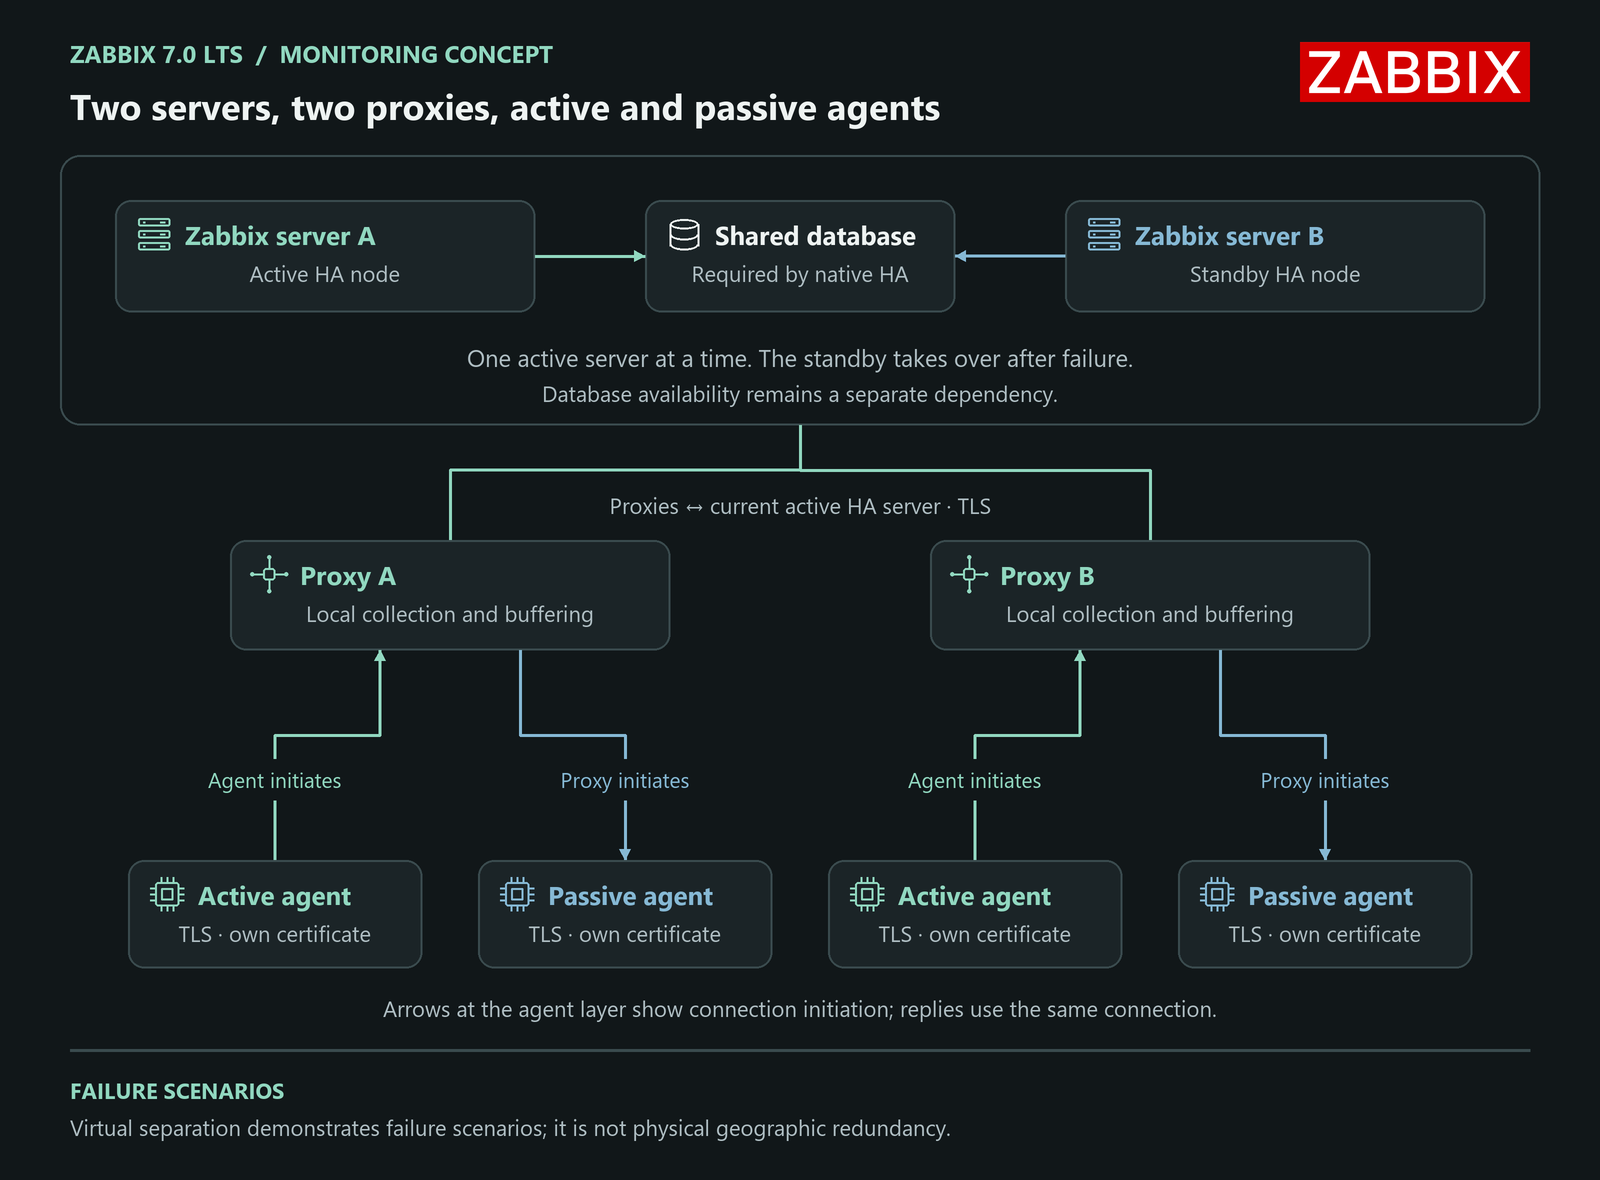
Die Abbildung zeigt zwei Zabbix-Server mit nativer HA: Einer arbeitet aktiv, der zweite steht für die Übernahme bereit. Beide verwenden dieselbe Datenbank. Deren Verfügbarkeit muss daher gesondert abgesichert werden. Proxies sammeln Daten bei den überwachten Systemen und können sie bei einer unterbrochenen Verbindung zum Server zwischenspeichern.
Bei aktiven Checks baut der Agent die Verbindung auf; bei passiven fragt der Proxy den Agent ab. Für eine automatische Übernahme zwischen Proxies ist eine konfigurierte Proxy-Gruppe erforderlich. Hostzuordnung, Agent-Konfiguration und Versionen müssen dazu passen.
Alarmierung bis zum Empfänger testen
Die Alarmierung läuft über Matrix, ergänzt um ein SMS-Fallback-Modul. Fail2ban überwacht definierte Muster in Zugriffslogs und meldet Ereignisse zusätzlich per E-Mail. Wichtig sind mir Meldungen mit einer konkreten Auswirkung und einer passenden Eskalation.
| Testfall | Erwartetes Ergebnis |
|---|---|
| Agent oder Verbindung fällt aus | Fehlende aktuelle Messwerte werden erkannt und gemeldet. |
| Aktiver Zabbix-Server stoppt | Der Standby übernimmt. Danach werden Datenfluss und nachgelieferte Werte geprüft. |
| Ein Proxy oder die Datenbank fällt aus | Die Auswirkung auf Erfassung und Auswertung wird sichtbar; die vorgesehene Übernahme wird geprüft. |
| Matrix ist nicht erreichbar | Die Eskalation über SMS erreicht den Empfänger trotz ausgefallenem Matrix-Dienst. |
Der SMS-Weg muss auch dann funktionieren, wenn Matrix ausfällt. Deshalb gehören seine Abhängigkeiten ebenfalls zum Test: Ein gemeinsamer Host, Internetzugang oder Stromkreis kann beide Wege gleichzeitig treffen. Solche Ausfälle bilde ich virtuell nach; eine räumliche Trennung der Standorte ist damit nicht nachgewiesen.
Fazit
Für mich beginnt gutes Monitoring beim Deployment und reicht bis zur Reaktion auf eine Meldung. Automatisierung spart wiederkehrende Handarbeit. Angepasste Checks, übersichtliche Dashboards und getestete Alarmwege machen daraus ein Werkzeug, auf das ich mich im Alltag verlassen kann.
Technische Referenzen: Zabbix 7.0: certificate authentication · Autoregistration · Server HA · Proxy groups · Housekeeping · Zero Trust: NIST SP 800-207